KI nutzen, ohne die Kontrolle über Ihre Daten abzugeben.
Die meisten KI-Tools schicken Ihre Firmendaten an fremde Server. Wir bauen KI, die bei Ihnen bleibt: DSGVO-konform, auf EU-Servern, ohne Datenabfluss.
Das Problem mit Standard-KI
Wer Dokumente, Kundendaten oder internes Wissen in öffentliche KI-Dienste gibt, gibt Kontrolle ab. In Standard-Abos ohne Auftragsverarbeitungsvertrag ist oft nicht geregelt, wo die Daten liegen, wer sie einsehen kann und ob sie ins Training einfließen. Auch mit Vertrag verarbeitet ein Dritter die Daten auf seinen Servern. Für viele Branchen ist das rechtlich schwer tragbar.
Datenabwanderung
Ihre Prozessdaten laufen über fremde Hyperscaler. Datenschutz wird dort zum nachträglichen Add-on, nicht zum Architekturprinzip.
Kontrollverlust
Wo die Daten liegen, wer sie sieht und ob damit trainiert wird, entscheiden Sie nicht mehr. Was einmal draußen ist, lässt sich nicht zurückholen.
Compliance-Risiko
Wer heute ohne Konzept startet, rüstet später teuer nach. DSGVO und EU AI Act verlangen Dokumentation, Transparenz und Kontrolle, die sich nachträglich nur mühsam einbauen lassen.
Datenhoheit ist kein Feature
Sie ist Architekturprinzip. Was bei uns wie selbstverständlich klingt, ist der Unterschied zu KI, die nur nachträglich abgesichert wurde:
Kein Abfluss von Geschäftsdaten
Prompt- und Trainingsdaten verlassen Ihr Hoheitsgebiet nicht, zu keinem Zeitpunkt.
Volle Kontrolle über das Modell
Sie bestimmen Version und Konfiguration. Kein stilles Update, keine Blackbox, keine Überraschung im Betrieb.
EU-Standorte als Grundlage
Datenverarbeitung nach europäischem Recht: DSGVO als Fundament der Architektur, nicht als nachträgliches Add-on.
Skalierung nach Budget
Vom schlanken Einstieg bis zur eigenen GPU-Maschine: Die Infrastruktur wächst mit Ihrem Bedarf.
Integration statt Insel
Eingebunden in Ihre bestehende IT-, Identity- und Zugriffsstruktur, die KI bleibt Teil Ihrer Landschaft.
Der Unterschied im Überblick
Souveräne KI zeichnet sich durch den Betrieb auf eigener Infrastruktur, lückenlosen Datenschutz nach DSGVO und volle Kontrolle über Unternehmensdaten aus. Im Gegensatz zu standardisierten US-Cloud-Diensten verlassen interne Dokumente, Verträge und Know-how zu keinem Zeitpunkt das eigene Netzwerk.
| Kriterium | Standard-KI | Souveräne KI |
|---|---|---|
| KI-Betrieb | Öffentliche US-APIs | Eigene Server oder dedizierte EU-Server, auf Wunsch im Haus |
| Datenschutz | Nachträgliches Opt-out | Datenschutz als Architekturprinzip |
| Arbeitsweise | Ungeprüft: „wird schon stimmen“ | Geprüft, mit festen Regeln und Rückfallwegen |
| Wissen | Flüchtiges Prompting | Eigene, strukturierte Wissensbasis |
| Kontrolle | Intransparente Blackbox | Freigebbar, auditierbar, Human-in-the-Loop |
| Abhängigkeit | Lock-in beim Anbieter | Software und Infrastruktur gehören Ihnen |
| Einstieg | Sofort, ohne eigene Technik | Aufbau nötig, danach unabhängig |
| Kosten über die Zeit | Nutzungsabhängig, steigen mit dem Volumen | Planbar, wächst mit der Rechenleistung statt pro Anfrage |
Voller KI-Nutzen, volle Kontrolle
Sie bekommen die Produktivität moderner KI (Automatisierung, Wissensabruf, intelligente Prozesse) ohne den Preis, den Standard-Tools verlangen: Ihre Daten. Sicher, compliant, und ohne dass sensible Informationen Ihr Unternehmen verlassen.
Und weil moderne Modelle längst nicht mehr nur antworten, sondern handeln können, bekommen Sie Systeme, die lesen, prüfen, buchen und melden, Agenten statt Chat. An den Stellen, an denen es zählt, entscheidet weiter ein Mensch: Kritische Schritte laufen über eine Freigabe. Jeder Vorgang wird protokolliert und bleibt nachvollziehbar.
Wir testen, was wir verkaufen
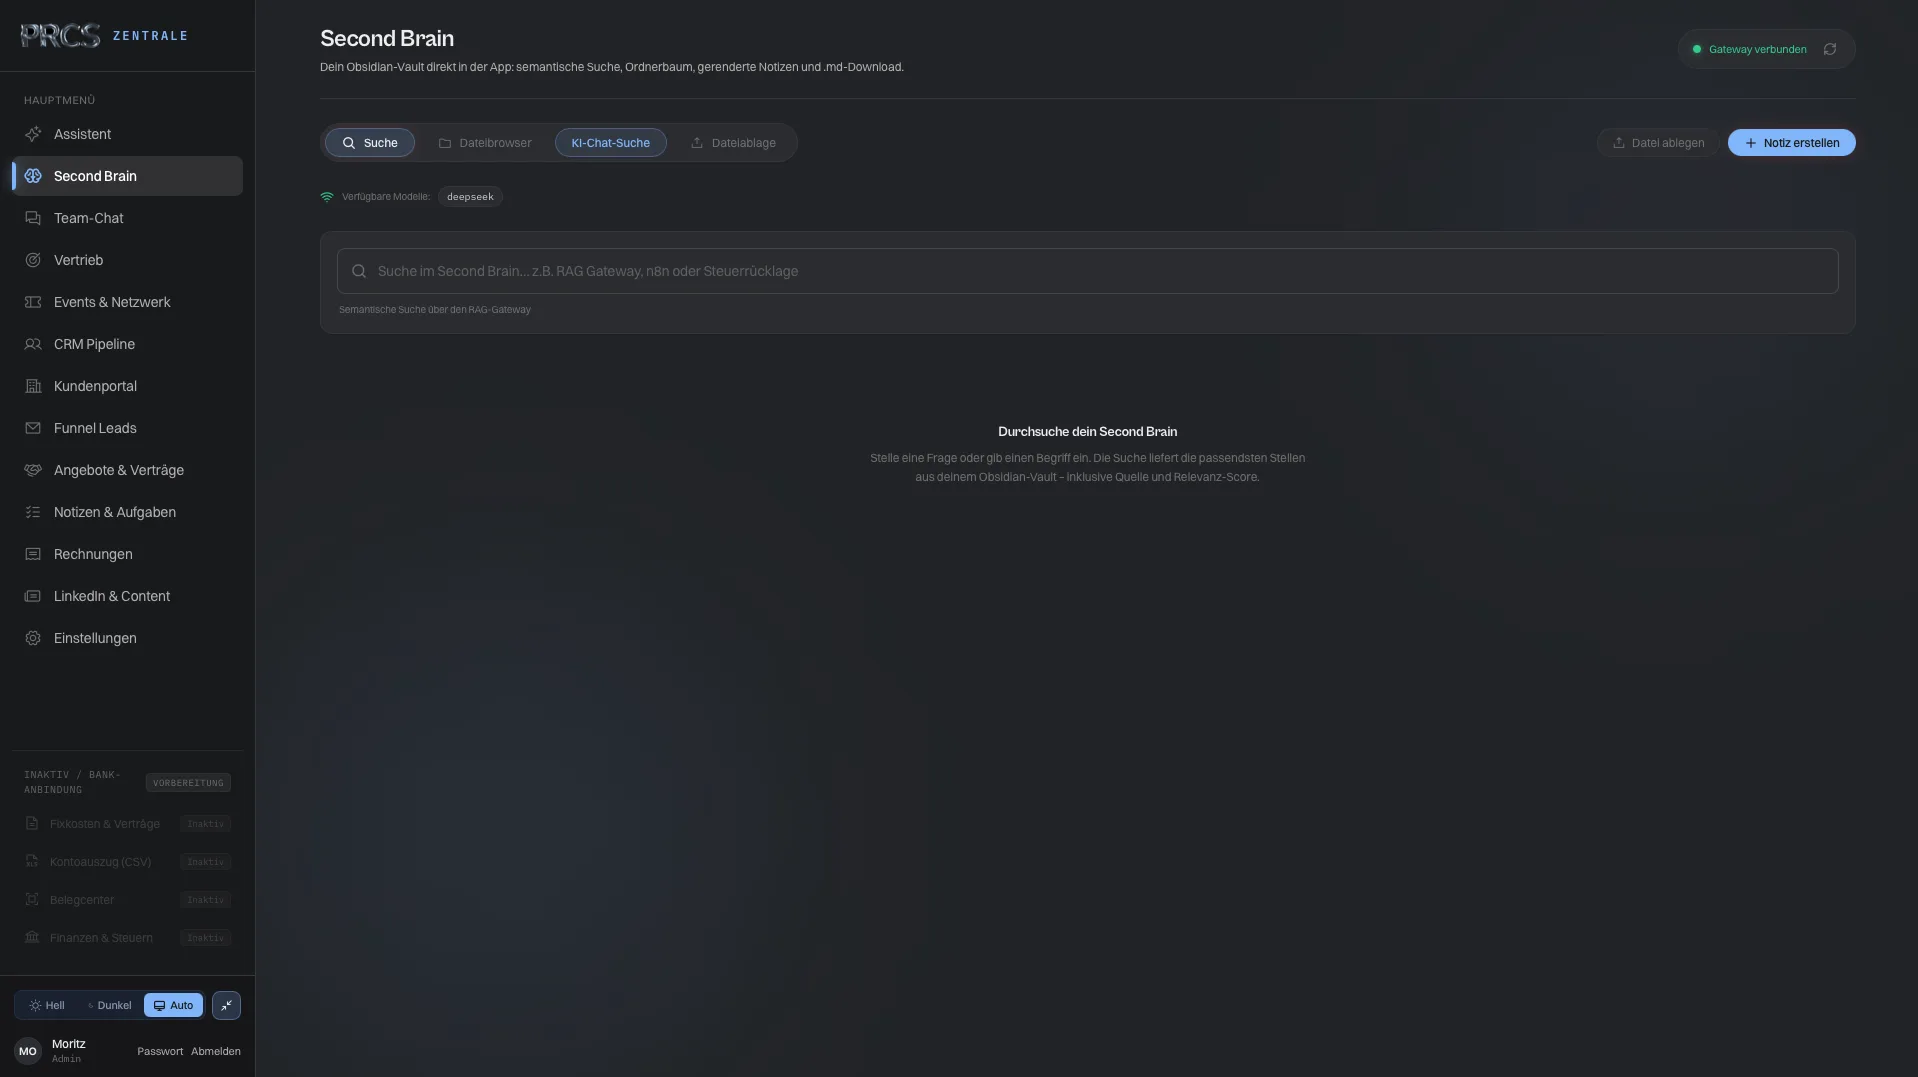
Unsere eigene Wissensdatenbank, unsere Assistenten und unsere Content-Pipeline laufen auf genau der Infrastruktur, die wir für Sie aufbauen, im Tagesbetrieb, mit denselben Regeln zu Datenhoheit, Zugriff und Freigabe. Wer Systeme verkauft, die er nicht selbst betreibt, verkauft eine Behauptung. Wir betreiben sie.
Eigene Wissensdatenbank
Unser Zweites Gehirn ist eine private Wissensbasis über alle Projekte, Kunden und Entscheidungen. Dieselbe Bauart bekommen Sie von uns.
Eigene KI-Assistenten
Assistenten, die auf diesem Wissen arbeiten und Aufgaben übernehmen: Recherche, Angebotsvorbereitung, Auswertung.
Eigene Content-Pipeline
Von der Rohnotiz zum fertigen Fachbeitrag: automatisiert, mit menschlicher Freigabe vor der Veröffentlichung.
Datenschutz ist kein Add-on
Datenschutz ist bei uns kein nachträglicher Zusatz, sondern Auslegungskriterium. Wir bauen so, dass Ihre Systeme datenschutzkonform betrieben werden können und die Anforderungen des EU AI Act erfüllbar bleiben: nicht, damit es nachträglich passt, sondern weil es von Anfang an so entworfen wurde.
DSGVO-konform
Verarbeitung nach europäischem Recht, mit Auftragsverarbeitung und dokumentierter Datenhaltung.
EU AI Act im Blick
Transparenz, Dokumentation und menschliche Aufsicht sind von Anfang an eingeplant statt später nachgerüstet.
Berufsrechtliche Verschwiegenheit
Für Kanzleien, Steuerberatung und Praxen: Systeme, die der beruflichen Schweigepflicht nach § 203 StGB Rechnung tragen.
Löschung und Aufbewahrung
Klare Regeln, welche Daten wie lange bleiben und was am Ende eines Projekts zurückgegeben oder gelöscht wird.
Unsere Prinzipien
Datensparsamkeit, Verschlüsselung, klare Zugriffskontrolle und Betrieb in Ihrer Kontrolle.
Datensparsamkeit
Nur die Daten, die der Prozess wirklich braucht.
Verschlüsselung
Auf dem Transportweg und im Ruhezustand.
Zugriffskontrolle
Rollen und Rechte, integriert in Ihre bestehende Struktur.
Betrieb in Ihrer Kontrolle
Wir konfigurieren, Sie besitzen.
Dazu gehört für uns ein Punkt, der selten ausgesprochen wird: kein Vendor-Lock-in. Software, Workflows und geistiges Eigentum gehören Ihnen, nicht uns.
Was vorher gefragt wird
Darf ich gar keine öffentliche KI nutzen?
Doch. Für allgemeine Fragen ohne Firmenbezug spricht wenig dagegen. Kritisch wird es, sobald Kundendaten, Verträge, Personalinformationen oder internes Wissen eingegeben werden. Diese Trennlinie beim Inhalt ist der eigentliche Entscheidungspunkt.
Welche Fragen sollte ich einem KI-Anbieter vorher stellen?
Drei: Wo liegt das Modell? Wer kann die Eingaben sehen? Und wird mit ihnen trainiert? Wer diese Fragen nicht beantworten kann, sollte keine Kundendaten, Verträge oder Personalakten hineingeben.
Was kostet eigene Infrastruktur wirklich?
Nicht nur Geld, sondern Aufmerksamkeit: Wer ein Modell selbst betreibt, braucht einen Plan für Updates, Ausfälle und Zugriffe. Deshalb ist der Betrieb in der Regel Teil der Lösung und keine Aufgabe, die am Ende offen bleibt.
Sind die Antworten eines eigenen Modells schlechter?
Im Unternehmenskontext oft besser. Ein Modell, das auf dem eigenen Firmenwissen arbeitet, kennt Ihre Begriffe, Ihre Kunden und Ihre Ausnahmen. Ein öffentliches Modell bringt nur sein Trainingswissen mit.
Sie wollen wissen, wo Ihre Daten heute liegen? Das klären wir im kostenlosen Prozess-Audit.Audit starten →